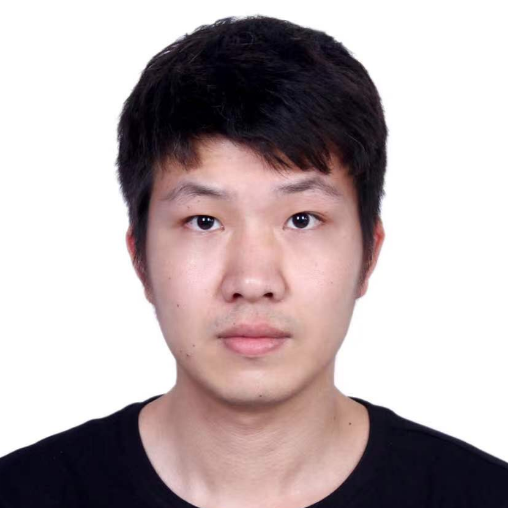
上海期智研究院PI,极熵智阅创始人。
本科毕业于清华大学,博士毕业于中国科学院大学,曾在清华大学交叉信息研究院从事博士后研究,并曾任职于北京智源人工智能研究院。主要从事大模型数据工程、AI for Math、形式化证明和AI医疗研究,主导构建的开源数据集在Hugging Face累计下载量超过160万次。目前负责PaperPulse的研发与落地。
大模型数据工程
AI for Math
成果1:DataPulse:面向下一代 AI Scientist 的科研数据基础设施
DataPulse 是一个面向科学发现、持续演化且可交互的科研数据环境。它将论文、专业科学数据、研究关系与证据链组织在统一的环境中,并持续吸收真实科研活动产生的研究轨迹、科学判断与反馈,为理解科学、规划研究和持续探索提供可积累、可追溯、持续更新的数据支撑。随着科学知识快速增长,科研的核心挑战正在从“获取信息”进一步转向“判断价值”。AI Agent 不仅需要检索论文和数据,还需要判断哪些工作真正重要、哪些证据更加可靠、哪些问题值得继续探索。这样的判断并不只存在于论文文本中,而是长期沉淀在科学家发现问题、阅读文献、比较证据、设计实验和调整研究方向的真实过程中。由此产生的 Research Trajectories(研究轨迹)与 Scientific Taste(科学判断与研究品味),是训练下一代 Scientific Research Agent 的重要数据资源。
PaperPulse 是我们构建的学术论文与知识发现平台,也是 DataPulse 与真实科研活动之间的重要连接。平台已汇聚 300 多万篇论文,并持续接入多学科专业科学数据和公共科研资源,通过个性化推荐、智能搜索、AI 阅读与科研社区,帮助研究者发现重要工作、理解研究进展并开展学术交流。科研人员在真实使用过程中形成的阅读、检索、判断、讨论与研究行为,可以进一步沉淀为高质量研究轨迹,为研究系统理解科学知识,以及学习优秀科学家如何发现重要问题、判断研究价值并推进科学探索,提供持续积累的数据基础。
SciencePulse 是我们自主构建的 Scientific Research Agent,也是 DataPulse 连接智能科研任务的重要载体。依托 DataPulse 提供的论文、专业科学数据、研究关系与证据链,SciencePulse 借助 Harness、Tools、Skills 与科研沙箱,面向文献研究、数据分析、实验设计、代码执行、结果分析与论文写作等任务,构建可交互、可追溯的研究过程。与 PaperPulse 连接研究者的知识获取与学术交流相呼应,SciencePulse 进一步面向科研问题的探索与研究任务的执行,让持续积累的科学知识与研究经验服务于具体科研实践。
PaperPulse 中真实科研活动形成的研究轨迹、科学判断与讨论,以及 SciencePulse 执行研究任务产生的过程记录、新结果和科研人员的反馈,可以持续沉淀到 DataPulse,形成知识—研究—反馈—再学习的闭环。DataPulse 为 PaperPulse 与 SciencePulse 提供数据与知识支持,产品使用和科研任务执行又不断丰富数据环境,为科研 Agent 的能力迭代与整个科研系统的持续演化提供基础。
最终,DataPulse 不只是一个论文数据库或科研知识库,而是连接科学知识、真实研究过程与人类科学判断的动态科研数据基础设施。它以统一的科研数据环境支撑 PaperPulse 与 SciencePulse,并为 Scientific Research Agent 的能力迭代,乃至下一代 AI Scientist 的构建,提供持续积累、不断更新的数据基础。
PaperPulse网址:www.paperpulse.com.cn

-----------------------------------
成果2:AutoMathText-V2:面向数学与科学推理的大规模预训练数据集
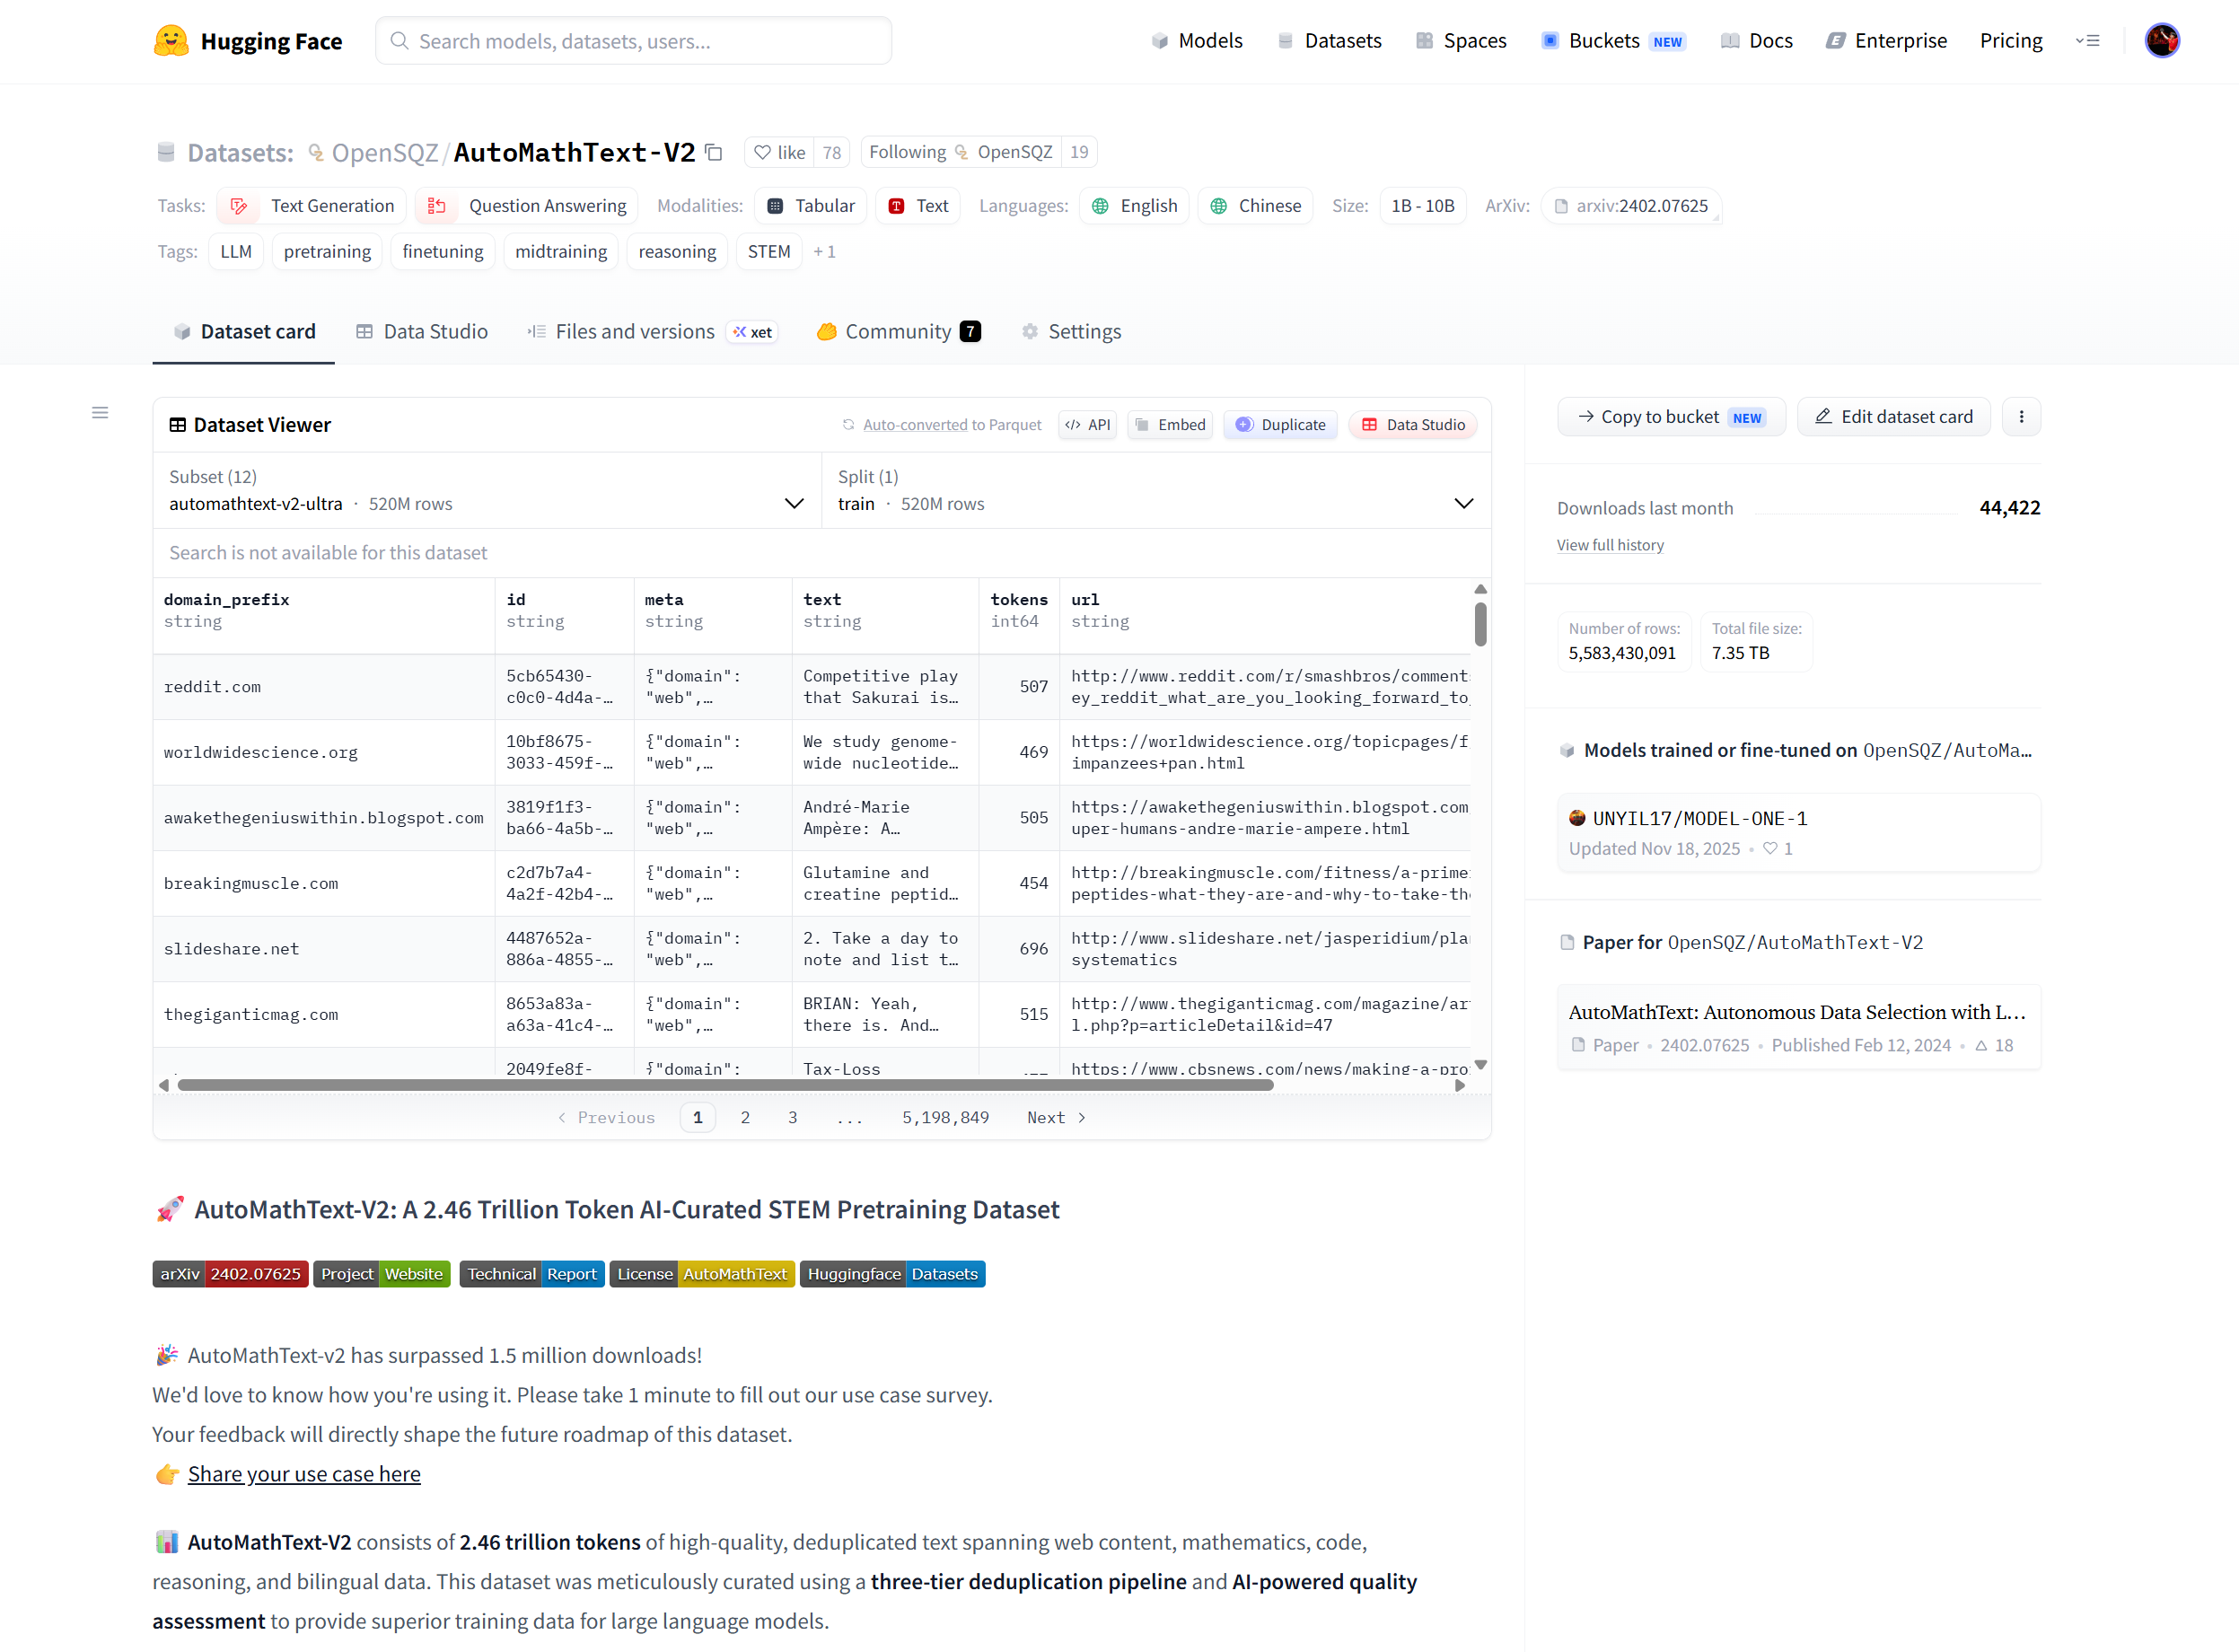
AutoMathText-V2 是我们构建并公开发布的、面向数学与科学推理的大规模预训练数据集。数据集汇集 50 多个数据源,构建了约 2.46 万亿 tokens 的多领域训练语料,覆盖数学、代码、推理问答、网页与教育文本,并包含中英文内容,为大语言模型的知识学习与推理能力训练提供数据基础。在数据构建过程中,AutoMathText-V2 采用精确去重、模糊去重和语义去重相结合的处理流程,并结合基于 Qwen2 的质量评估、文本清洗与测试集污染检测,对多源语料进行筛选和整理,减少重复内容与低质量文本,降低训练数据中的测试集泄漏风险。 同时,数据集按领域和质量等级组织数据,支持研究者依据不同训练目标选择和组合使用,为模型训练与数据配比研究提供可复用的语料资源。目前,AutoMathText-V2 已在 Hugging Face 公开发布,下载量达到 160 万+。该成果将多源语料整合、自动化质量筛选与规模化数据处理沉淀为公开的数据资源,为数学推理、科学知识学习及相关模型研究提供数据支持。
数据集地址:https://huggingface.co/datasets/OpenSQZ/AutoMathText-V2